DGX Station(GWS-GB300SM / GWS-GB300AS)

NVIDIA DGX Station
データセンター級の性能を、手元の開発環境に。
NVIDIA DGX Station は、GB300 スーパーチップを搭載した共通プラットフォームです。ジーデップ・アドバンスでは設置環境や運用方法に合わせて2機種から選べます。
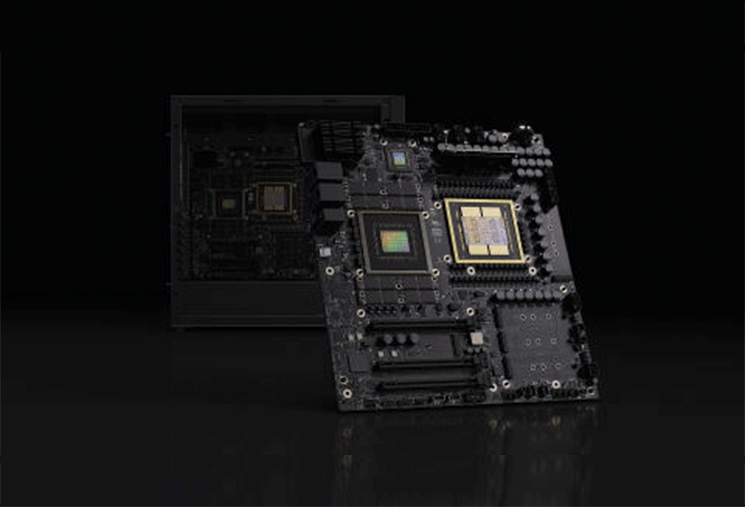
GB300 スーパーチップ搭載
72コアのGrace CPUと252GB HBM3e搭載のBlackwell Ultra GPUを統合。最大20 PFLOPSのAI性能で、1兆パラメータ級のモデルに対応します。
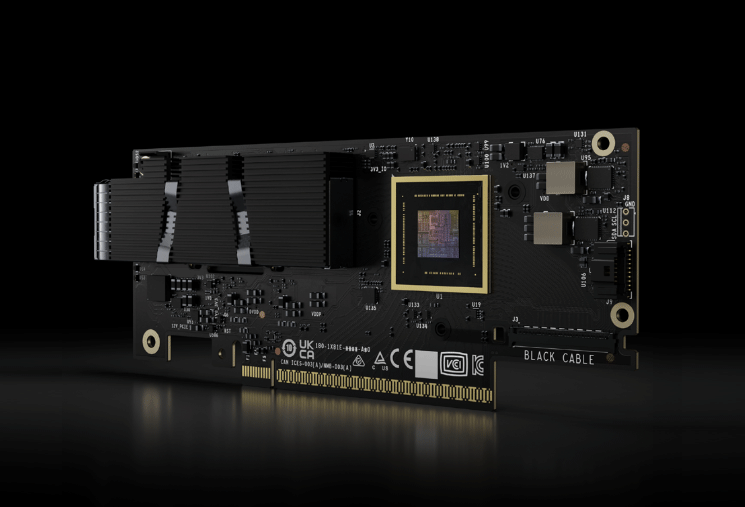
400GbE×2 と MIG 最大7分割
ConnectX-8 SuperNICにより、最大800Gb/sの高速ネットワークに対応。GPUを最大7つのMIGに分割し、複数ユーザーで共有できます。
すぐ使える開発環境
Ubuntu 24.04とNVIDIA AI Developer Toolsをプリインストール。可視化用途には、NVIDIA RTX PRO GPUを1基増設可能です。
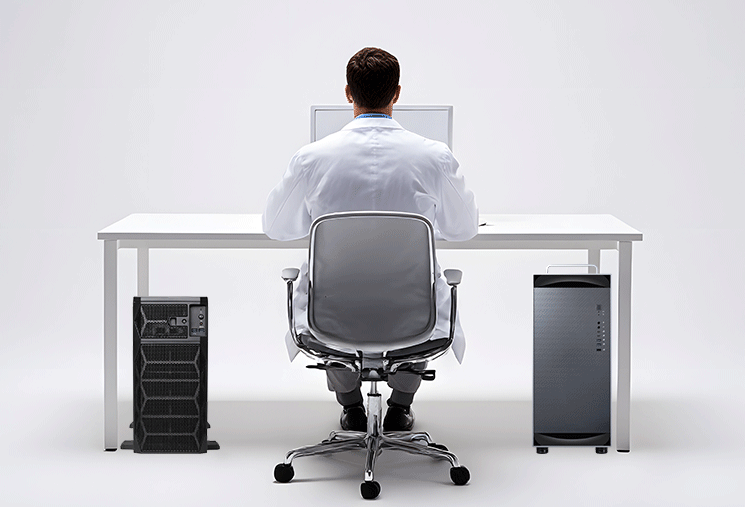
デスクサイドに設置可能
研究室やオフィスにも設置可能。最大消費電力が1.6kWのため、電源環境の確認が必要です。
⚡ 電源要件単相200V電源を推奨。
748GBを構成する、2種類のメモリ
GB300の748GBコヒーレントメモリは、252GBのGPUメモリ(HBM3e)と496GBのCPUメモリ(LPDDR5X)で構成されています。それぞれ容量・帯域・役割が異なるため、モデルサイズやデータの配置によって、対応できるワークロードと実効性能が変わります。
例:200GBのモデル+300GBのKVキャッシュ=合計500GB。重みをHBM3eに、KVキャッシュをLPDDR5Xに置けば、1台のメモリに載せたまま動かせます。量子化すれば100B超のモデルも1台に収まります。
1チップあたりの性能が、業界最高クラス
GB300の実測スループットと、主要GPUとのチップ単位の比較です。
- モデル
- Qwen3.5-122B-A10B(FP8)。MoEのため、122Bのうち1回の処理で実際に動くのは約10Bです。
- 実行環境
- vLLM / 1ノード
- 入出力
- 入力512トークン・出力512トークン
- 上記はMoEモデルでの数値です。総パラメータ数が同じでも、一般的な(Dense)モデルでは同じ性能になりません。
- モデル・量子化方式・バッチサイズ・コンテキスト長・推論フレームワークによって結果は変わります。
- GB300は2機種で共通のため、GWS-GB300SM・GWS-GB300AS のどちらでも同等の性能です。
GPU Memory per Chip
1チップあたりのGPUメモリ容量(GB)
Max LLM Size per GPU
1GPUで対応可能なLLM規模の目安(10億パラメータ単位)
AI PetaFLOPS — Chip to Chip
チップ単位のAI演算性能(各GPUで最も低いFP精度で比較)
※ 各GPUで利用可能な最小FP精度(FP4 / FP8 / FP16)での比較値です。
複数台構成で、推論サービスの処理能力を拡張1台から始めて、利用規模に合わせて拡張
DGX Stationはネットワークによるスケールアウトに対応し、扱えるモデル規模や総スループット、同時ユーザー数を拡張できます。
※単一ワークロードの処理速度が単純に向上するものではありません。
ネットワークは ConnectX-8 の 400GbE QSFP ×2(単ポート400Gb/s ≒ 50GB/s、2ポート束ねて800Gb/s ≒ 100GB/s)。現時点では Ethernet モードのみの対応で、InfiniBand モードは非対応です。
| 目的 | 1ノードモデル全体を1台に配置 | データ並列各ノードにモデル全体を複製 | パイプライン並列モデルを層で分割し複数ノードに配置 |
|---|---|---|---|
| 一般的な推論 | 推奨 | — | — |
| 同時ユーザー数を増やしたい | 可 | 推奨 | — |
| モデルが 252GB HBM に載らない | — | — | 推奨 |
| 長いコンテキストを扱いたい | 対応 ※1 | 対応 ※1 | — |
| 構成の特徴 | 最も低遅延/構成が単純 跨ノード通信なし | 各ノードが完全なモデルを保持 ロードバランサで分散 | 層/ステージで分割配置 中間データを400GbEで転送 |
※1 実効性能は、KVキャッシュの使用量やコンテキスト長などの条件によって異なります。単一システムのHBM3eに収まるモデルでは、パイプライン並列によってノード間通信が発生し、遅延が増加する可能性があるため、通常は単一ノードでの実行を推奨します。
基本性能は共通。選定のポイントは、設置方法と冷却方式設置環境に合わせて選べる、2つのDGX Station
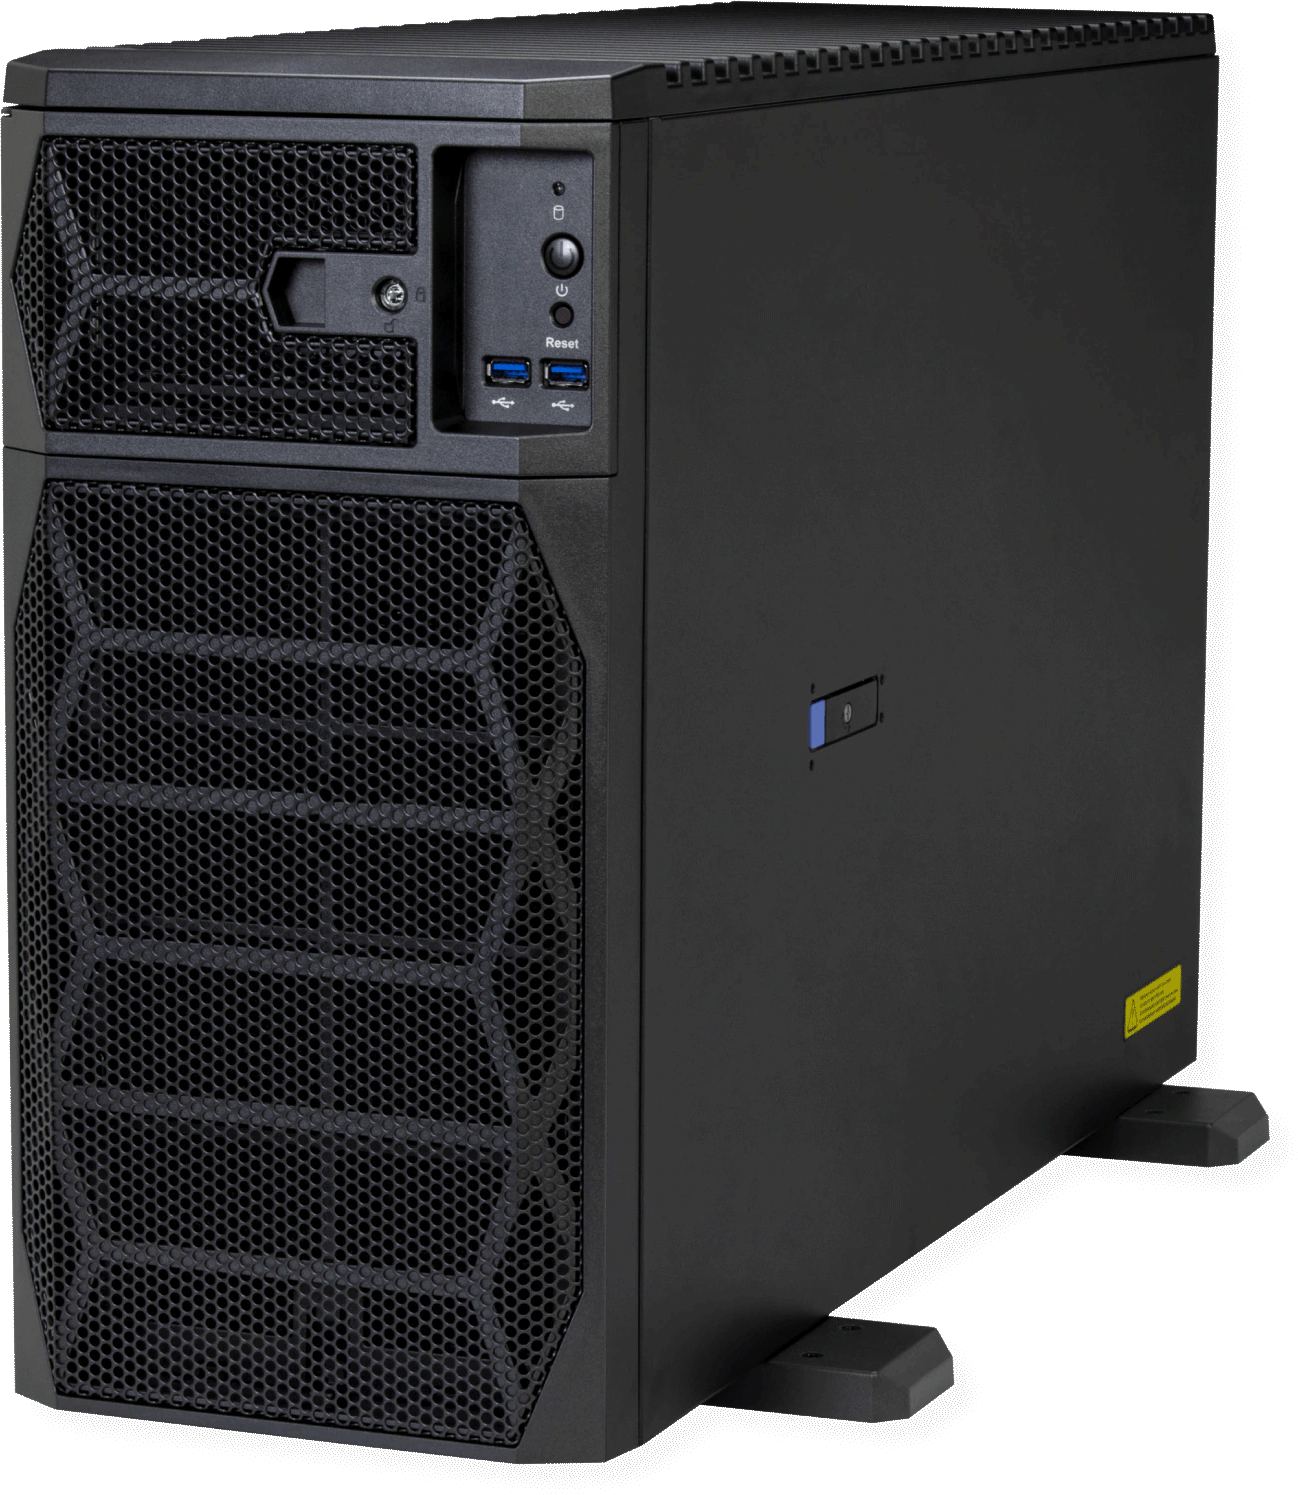
NVIDIA DGX Station
GWS-GB300SM
Direct-to-Chip水冷を採用、ラック搭載対応モデル。
- ラックマウント対応
デスクサイドからサーバールームへ、そのまま移設可能。5Uタワーのままラックに搭載できます。 - 大型ラジエーター+Direct-to-Chip 閉ループ液冷
筐体内に独立した水冷システムを搭載。施設側の水冷設備を必要とせず、長時間の連続稼働でも安定した性能を維持します。 - 高さ454.7mmの低背設計
棚下やラック内など、高さに制限のある場所にも収まります。
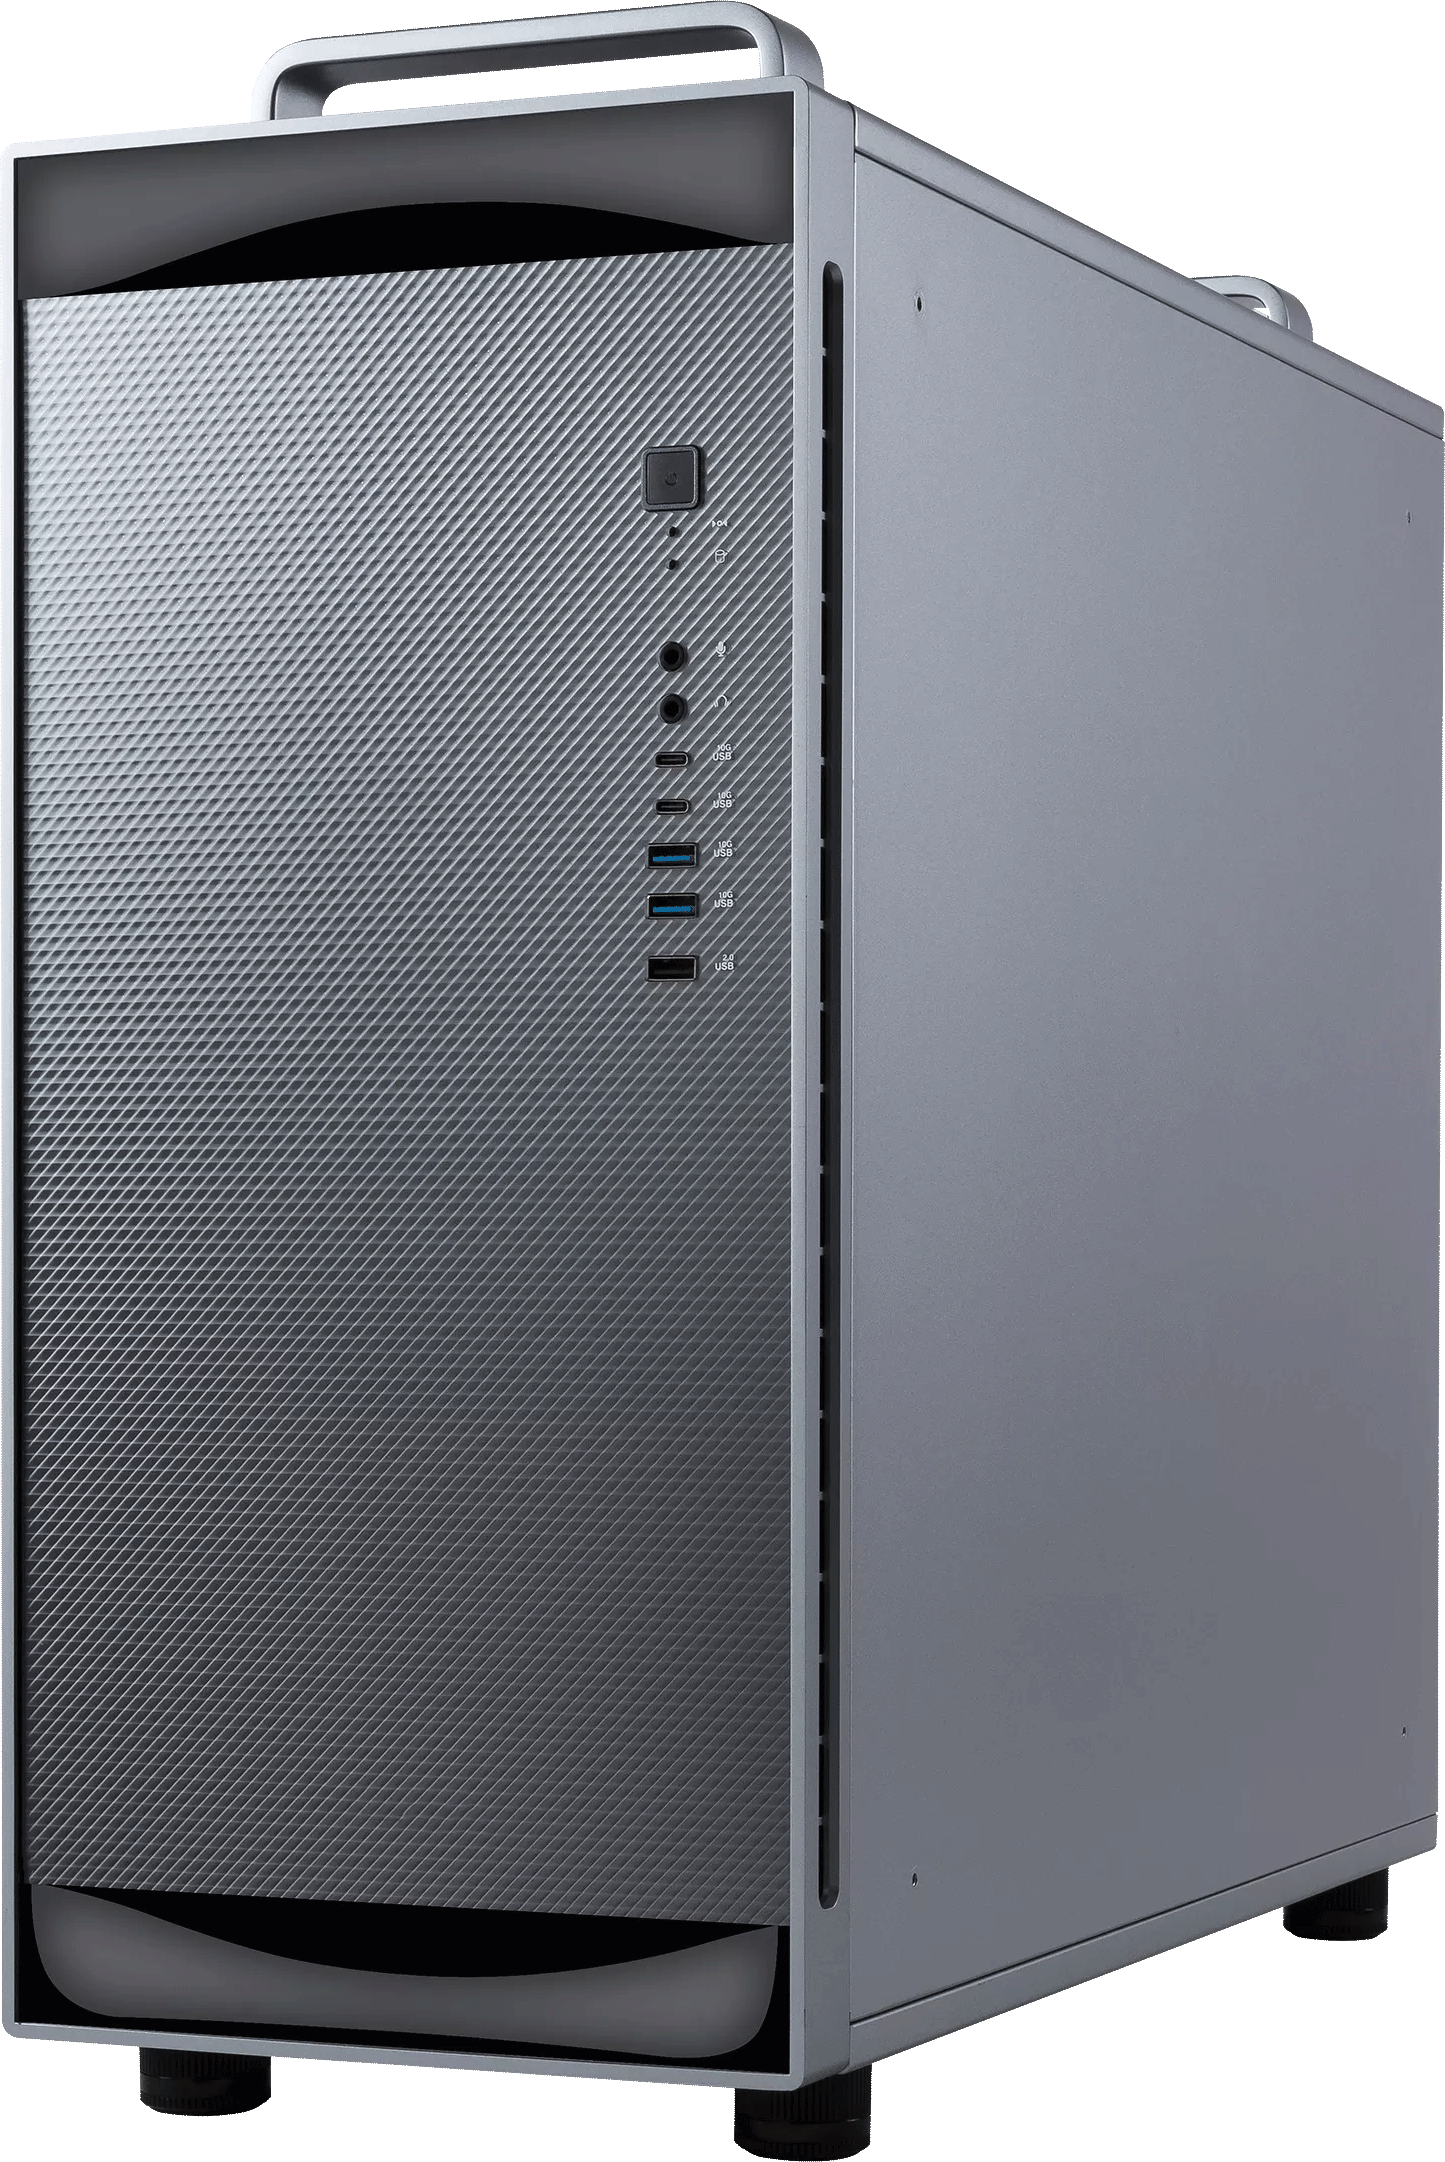
NVIDIA DGX Station
GWS-GB300AS
軽量な筐体と管理ソフトウェアを備えたデスクサイド向けモデル
- 本体27kg・奥行584mm
GB300搭載機のなかで最軽量。GWS-GB300SM より117mm浅く、一般的なデスク下に収まります。 - 管理ソフトウェア「Intelligent Hub」をプリインストール
Hugging Face からのモデル配備、MIG の分割設定、OpenAI 互換 API キーの発行まで、ブラウザ上で完結します。 - 執務室に映えるアルミ筐体
シルバーのアルミ筐体に、天面のキャリングハンドル。来客のある部屋やデスクサイドにもそのまま置けます。
※ 上の2枚の製品画像は、実際の高さの比率(565mm : 454.7mm)に合わせて表示しています。
内部構造の比較
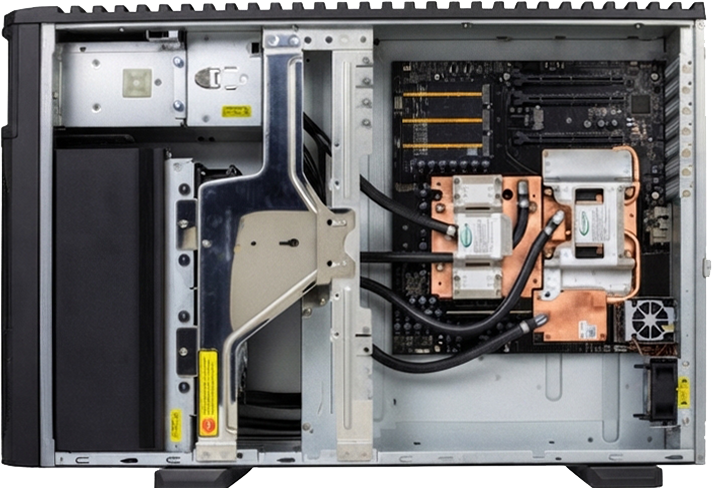
大型ラジエーター方式
コールドプレートから伸びた配管が、筐体の左端をまるごと占める大型ラジエーターへ。閉ループのため施設側の給水配管は不要です。この作り込みが持続的な性能を支えています。
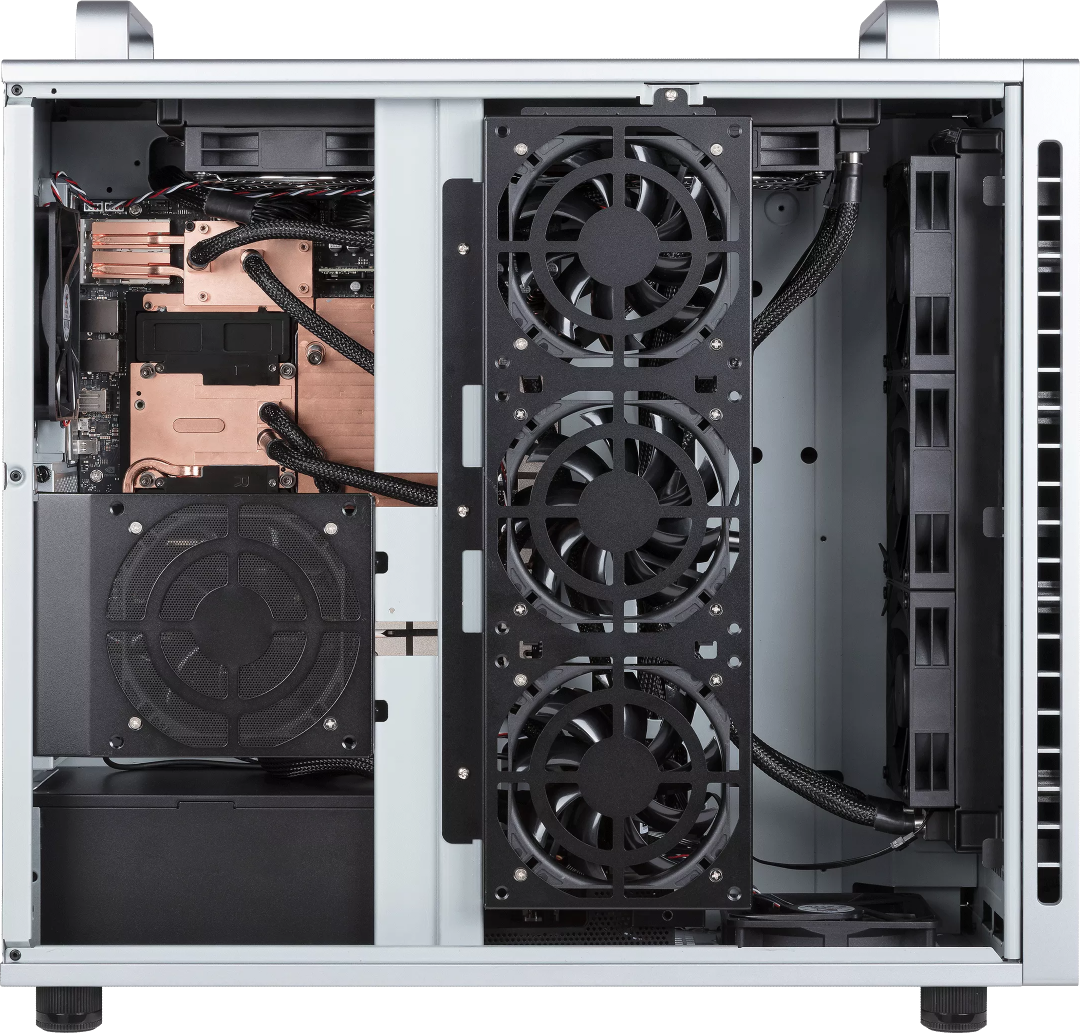
コンパクト水冷方式
コールドプレートから中央のラジエーター+3連ファンへ。通常の使用に対して十分な冷却性能を、コンパクトな構成で確保しています。
サイズ比較
選定ポイントとなるサイズの違い。
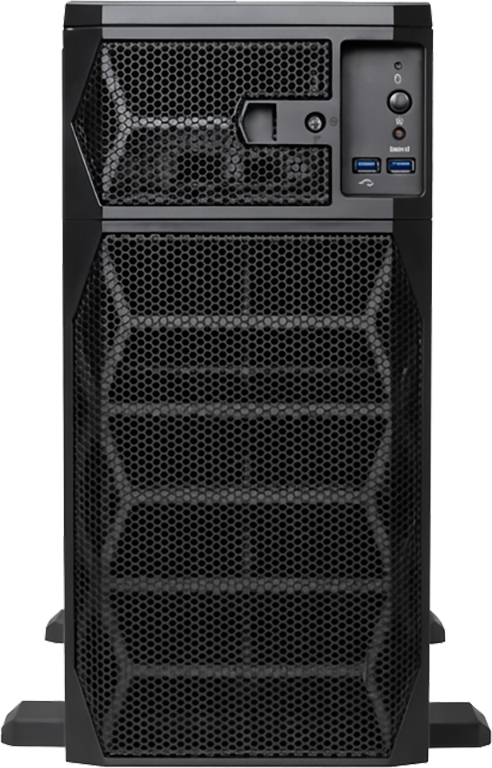
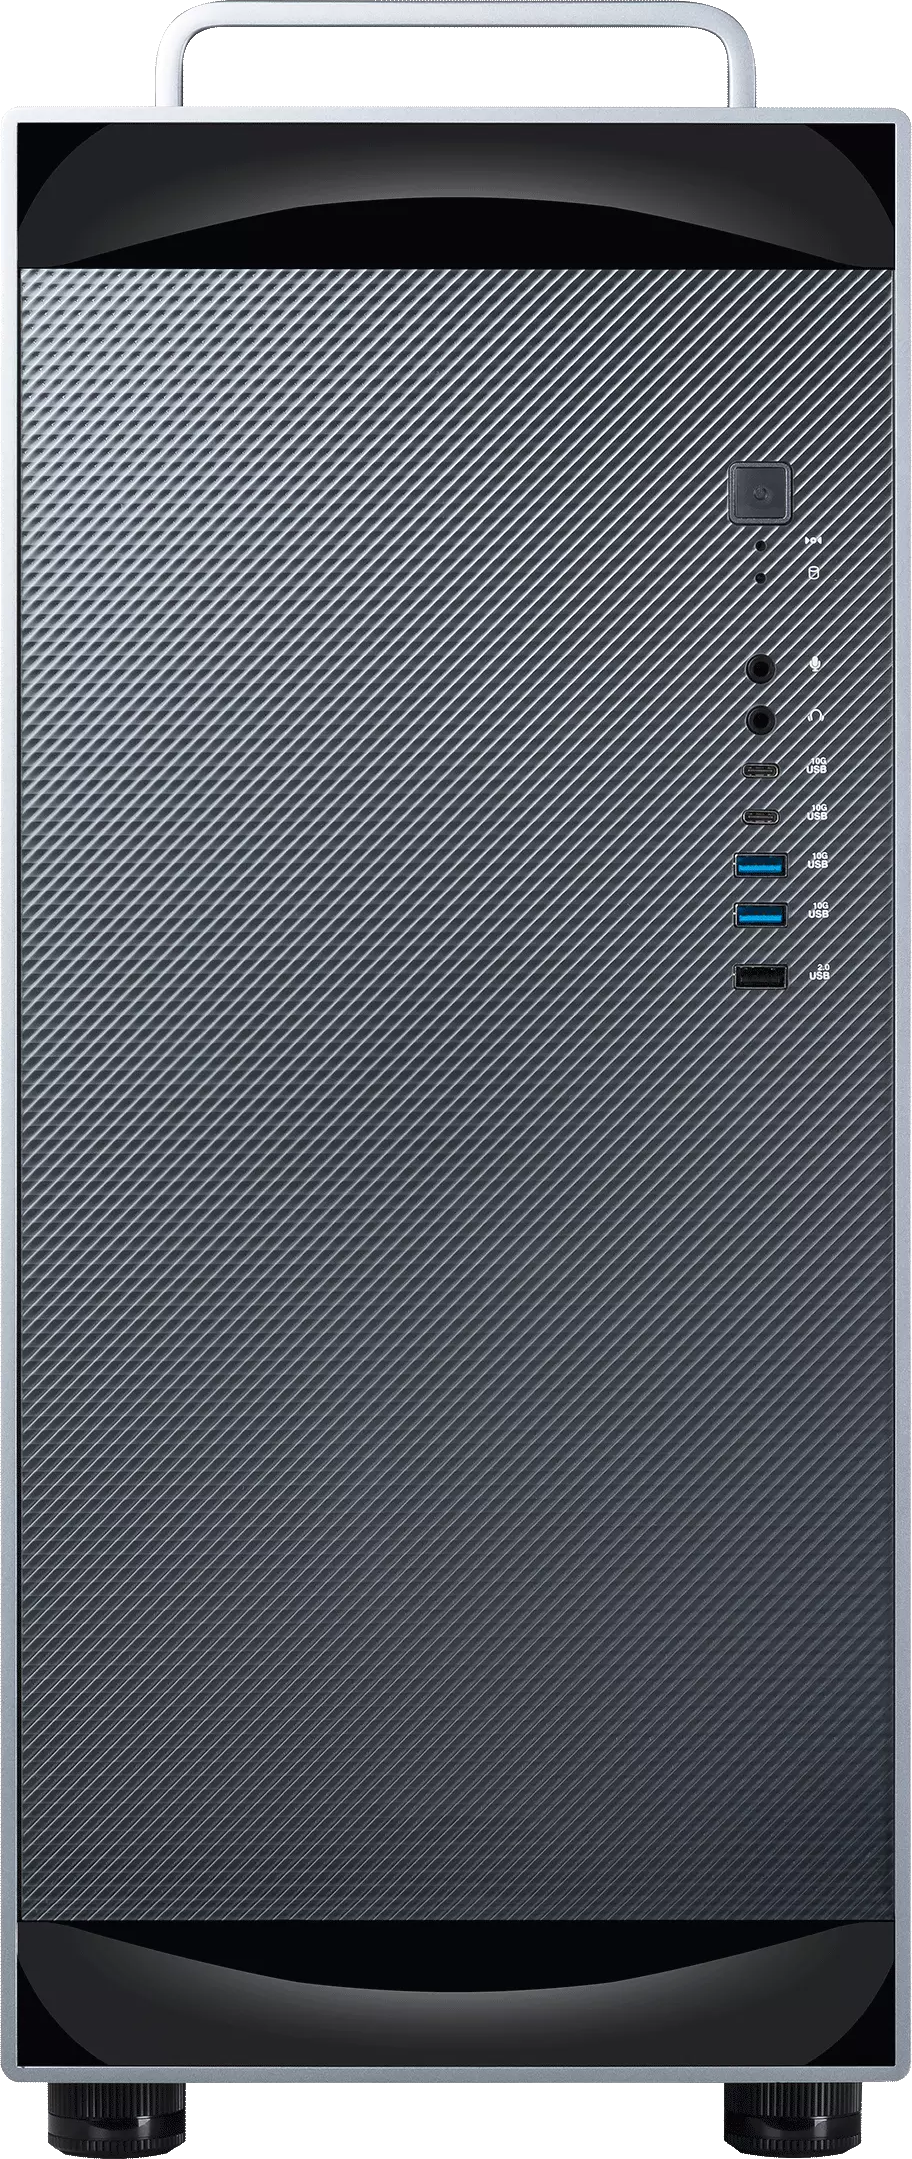
※ 実際の高さの比率で表示しています。
GWS-GB300SM は左右に張り出したスタビライザー脚を含むため横幅が広く見えますが、GWS-GB300ASより狭いです。
| 項目 | GWS-GB300SM | GWS-GB300AS |
|---|---|---|
| 共通スペック |
|
|
| 設置形態 | 5Uタワー / ラックマウント対応 | タワー天面キャリングハンドル付き |
| 冷却機構 | 大型ラジエーター+D2C 閉ループ液冷筐体左端をまるごと冷却に使用 | コールドプレート+AIO 一体型水冷通常使用には十分な冷却性能 |
| 本体重量 | 約 40 kg | 約 27 kg |
| 寸法 W×H×D | 218.4 × 454.7 × 701 mm | 232 × 565 × 584 mm |
| 筐体 | ブラック / サーバ筐体の意匠 | シルバーのアルミ筐体 |
| 管理ソフトウェア | NVIDIA 標準ソフトウェア | NVIDIA 標準ソフトウェア + Intelligent Hubプリインストール/モデル配備・MIG設定・OpenAI互換API発行 |
導入環境に適したモデルの選び方
設置環境と運用方法に合わせて、適した機種をご提案します。
お客様に最適な機種と構成をご提案します。
お見積り、デモのご依頼も承ります。
GPU製品ラインナップ仕様
最新のGB300(オレンジの箇所)以外にも用途に応じて、データセンター規模のGPU まで幅広くご提案します。
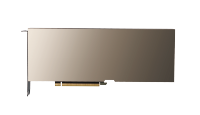
| 仕様 | NVIDIA GB300 |
NVIDIA H200 NVL |
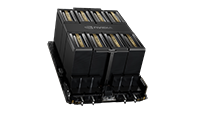
NVIDIA HGX B200 |
NVIDIA HGX B300 |
|---|---|---|---|---|
| 製品画像 |  |
 |
 |
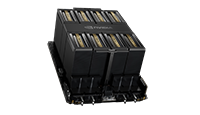 |
| フォームファクター | Grace Blackwell | PCIe デュアルスロット空冷 | 8× Blackwell SXM | 8× Blackwell Ultra SXM |
| FP64 / FP64 Tensor コア | 1.3 TFLOPS | 30 / 60 TFLOPS | 296 TFLOPS | 10 TFLOPS |
| FP32 | 80 TFLOPS | 60 TFLOPS | 600 TFLOPS | 600 TFLOPS |
| TF32 Tensor コア * | 2.5 PFLOPS | 835 TFLOPS | 18 PFLOPS | 18 PFLOPS |
| FP16 / BF16 Tensor コア * | 5 PFLOPS | 1,671 TFLOPS | 36 PFLOPS | 36 PFLOPS |
| FP8 / FP6 Tensor コア * | 10 PFLOPS | 3,341 TFLOPS | 72 PFLOPS | 72 PFLOPS |
| FP4 Tensor コア ** | 20 | 15 PFLOPS | — | 144 | 72 PFLOPS | 144 | 105 PFLOPS |
| INT8 Tensor コア * | 330 PFLOPS | 3,341 TFLOPS | 72 PFLOPS | 2 PFLOPS |
| メモリ | GPU 252GB / CPU 496GB | 141 GB | 1.4 TB | 最大 2.3 TB |
| メモリ帯域 | GPU 7.1TB/s / CPU 396GB/s | 4.8 TB/s | — | — |
| NVLink 帯域幅 | NVLink-C2C 900 GB/s | — | 14.4 TB/s | 14.4 TB/s |
| NVIDIA NVSwitch | NVLink 5 スイッチ | — | NVLink 5 スイッチ | NVLink 5 スイッチ |
| NVSwitch GPU間帯域 | — | — | 1.8 TB/s | 1.8 TB/s |
| 最大熱設計電力 (TDP) | — | 最大 600W(設定可能) | — | — |
* 構造的スパース性を含む値です。 ** FP4は「スパース | 密」の順で記載。 H200 NVLは前世代(Hopper)製品のため一部行で規格が異なります。
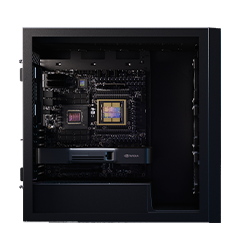
研究開発から本番運用まで幅広いワークロードに最適化
ディープテック・学術研究から、データサイエンス、AIアプリ開発まで。1台で多様な用途をカバーします。


製品仕様 — NVIDIA DGX Station(GWS-GB300xx)
いずれも NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip を搭載した NVIDIA 認定の DGX Station です。
| 項目 | GWS-GB300SMラックマウント対応モデル | GWS-GB300AS軽量・省設置モデル |
|---|---|---|
| プロセッサ / GPU | ||
| チップセット | NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip | |
| CPU | NVIDIA 72コア Grace ARM CPU(Neoverse V2) | |
| GPU | NVIDIA Blackwell Ultra B300 GPU(252GB HBM3e)/オンボード1基 | |
| CPU-GPU 相互接続 | NVIDIA NVLink-C2C(900 GB/s) | |
| FP4 演算性能 | 最大 20 PFLOPS | |
| 対応モデル規模 | 最大 1兆(1T)パラメータ級モデル | |
| GPU 分割 | MIG 最大7インスタンス | |
| 追加GPU | NVIDIA RTX PRO 6000 Blackwell Max-Q / RTX PRO 4000 Blackwell SFF / RTX PRO 2000 Blackwell を1枚(演算性能は合算されません) | |
| メモリ | ||
| 統合メモリ | 748GB コヒーレント(GPU側 252GB HBM3e + CPU側 496GB LPDDR5X) | |
| GPUメモリ帯域 | 252GB HBM3e / 7.1 TB/s | |
| CPUメモリ帯域 | 496GB LPDDR5X / 396 GB/s | |
| ネットワーク / I/O | ||
| ネットワーク | 2× 400GbE(オンボード ConnectX-8 SuperNIC、最大 800Gb/s)※現時点では Ethernet モードのみ対応 | |
| 管理LAN | 1× 10GbE + 1× 1GbE(BMC 専用) | |
| 無線 | Wi-Fi 7 モジュール(標準構成に搭載) | |
| USB / 映像 | 前面・背面 USB Type-A / Type-C 1× mini-DisplayPort | 前面 USB-C 10G×2・USB-A 10G×2・USB2.0 背面 USB-A 10G×4・1× mini-DisplayPort |
| ストレージ / 拡張 | ||
| ドライブ | M.2 2280 NVMe ×4(OS用 RAID + 学習データ用)/ 標準構成 2TB×2=4TB、最大 8TB | |
| 拡張スロット | PCIe Gen5 ×3(x16/x8/x8) | |
| 冷却 / 電源 / 筐体 | ||
| 冷却 | 大型ラジエーター+Direct-to-Chip 閉ループ液冷 | コールドプレート+AIO 一体型水冷 |
| 電源 | 1600W Titanium Level 電源 / 単相200V(AC200〜240V)を推奨します。 | |
| フォームファクタ | 5U タワー(ラックマウント対応) | タワー(天面キャリングハンドル付き) |
| 寸法 W×H×D | 218.4 × 454.7 × 701 mm | 232 × 565 × 584 mm |
| 重量 | 約 40 kg | 約 27 kg |
| 筐体 | ブラック | シルバー(アルミ) |
| ソフトウェア / 保守 | ||
| OS | Ubuntu 24.04+(NVIDIA AI Developer Tools プリインストール) | |
| 管理ソフトウェア | — | Intelligent Hub(プリインストール) モデル配備(Hugging Face/ローカルパス)・MIG 設定・OpenAI 互換 API 発行 |
| 保守 | 3年 翌営業日オンサイト保守(標準構成) | |
※ 仕様は予告なく変更される場合があります。最終仕様・構成はお問い合わせください。
※ 緑色の項目が2機種で異なる箇所です。それ以外の行は共通スペックです。
よくあるご質問
デスクサイドに設置できますか?電源の条件は?
NVAIE(NVIDIA AI Enterprise)は付属しますか?
GPUを追加で搭載できますか?
搭載OSについて教えてください。
- NVIDIA DCGM(Data Center GPU Manager)
- NVIDIA CUDA Toolkit
- NVIDIA Container Toolkit
- NVIDIA グラフィックスドライバ
- NVIDIA DOCA ソフトウェアフレームワーク
- NVIDIA Optimized Kernel
- NVIDIA GPUDirect Storage
DGX Spark を複数台の連結と比較して DGX Station を選ぶ理由は何ですか?
- DGX Spark 1台比:演算20倍(20 petaFLOPS FP4 / Sparkは1 petaFLOP)、コヒーレントメモリ5倍(748GB / 128GB)、メモリ帯域23倍
- DGX Spark 4台比でも:生演算5倍、メモリ・帯域とも上回る
- 2台構成:40 petaFLOPS(マルチSpark構成は4 petaFLOPS)
- データセンターのGB300 NVL72と同一のGB300アーキテクチャを持つ唯一のローカルシステムで、デスクからAIファクトリーへワークロードをシームレスに移植可能
AIアプリケーションやシステム構築もサポートされますか?
大規模LLM・生成AIを、ローカルで。
仕様のご相談、お見積り、デモのご依頼など、お気軽にお問い合わせください。機種選定の段階からご相談いただけます。
どちらのフォームからでも、機種の選定を含めてご相談いただけます。