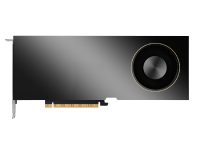


NVIDIA AmpereアーキテクチャGPU NVIDIA A800 40GB Active

NVIDIA® A800 40GB Activeは、NVIDIA Ampere アーキテクチャを採用した、デスクサイドワークステーション向けのコンピューティングGPUです。倍精度演算をサポートし、HPCアプリケーションにおいて最大9.7TFLOPSのFP64性能を発揮します。40GBのHBM2メモリーを搭載し、GPU間は第3世代NVLinkによる400GB/秒の高速インターコネクトで接続。マルチインスタンスGPU(MIG)により、1基のGPUを最大7つのインスタンスに分割し、複数ユーザーや複数ジョブでGPUリソースを共有できます。データセンターに設置することなく、研究者の手元でマルチGPUの計算環境を確保したいという用途に適しており、AI学習、AI推論、構造解析(CSM)、流体解析(CFD)、電磁界解析といったCAEシミュレーションの計算時間を短縮します。本製品にはNVIDIA AI Enterpriseの3年間サブスクリプションが付属し、エンタープライズ向けのサポートと最適化済みのソフトウェアスタックを利用できます。当社では、本製品の動作を検証したワークステーションとあわせてご提供します。
NVIDIA A100とNVIDIA A800 40GB Activeの比較
NVIDIA A800 40GB Activeは、NVIDIA A100と同等の仕様を備えており、デスクサイドでの利用にはNVIDIA A800 40GB Activeの搭載を推奨します。
| 仕様 | NVIDIA A100 40GB PCIe | NVIDIA A800 40GB Active |
| GPUメモリー | 40GB HBM2 | |
| メモリーインターフェース | 5120-bit | |
| メモリー帯域幅 | 1555.2GB/s | |
| CUDAコア | 6912 | |
| Tensorコア | 432 | |
| 倍精度(FP64)演算性能 | 9.7TFLOPS | |
| 単精度(FP32)演算性能 | 19.5TFLOPS | |
| マルチインスタンスGPU(MIG) | 最大7インスタンス | |
| NVIDIA NVLink | 対応(×3) | 対応(×2) |
| NVLink帯域幅 | 600GB/s | 400GB/s |
| システムインターフェース | PCIe 4.0 x16 | |
| 消費電力 | 250W | 240W |
| 冷却方式 | Passive(パッシブ) | Active(アクティブ) |
| フォームファクター | 高さ4.4インチ×長さ10.5インチ、デュアルスロット | |
| ディスプレイ出力 | なし | |
| 補助電源コネクタ | 1x CPU 8-pin | 1x PCIe CEM5 16-pin |
| 重量 | 1240g | 1182g |
NVIDIA A800 データシートカタログ(PDF)をダウンロードいただけます。
レンタルでの導入も可能
GPUレンタルには、初期投資を抑えられるというメリットがあります。高性能なGPUを購入することなく、必要な期間だけご利用いただけるため、コスト効率を重視される場合にお勧めです。ご希望の場合は、見積もり画面からお選びいただけます。
- Ampere
- PCIe 4.0
- HBM2
- 40GB
- [FP32]19.5 TFLOPS
- 9.7TFLOPS
- 3年保証