search製品名・スペックから検索


【第1回】DGX Spark 複数台接続による LLM 推論・学習速度の評価 ~推論編~
はじめに
NVIDIA DGX Spark は、GB10 Grace Blackwell Superchip と 128GB の統合メモリを搭載した、机の上に置ける AI 開発機です。単体で 100B クラスの量子化モデルが動くことは広く知られていますが、「では2台、4台つないだらどうなるのか」については、まとまった実測データがほとんどありませんでした。
今回、DGX Spark を1〜4台接続したクラスタ上で LLM の推論・学習を実行した評価レポートを掲載します。
- 第1回(本記事):概要/背景と目的/評価環境/vLLM と評価指標/推論速度評価
- 第2回:ノード間帯域の実測(NCCL Test)/学習速度評価
- 第3回:QSFP スイッチ利用時の通信速度低下問題/補足事項/まとめと今後の予定
1. 概要(エグゼクティブサマリ)
本レポートは,NVIDIA DGX Spark を 1〜4 台接続したクラスタ上で大規模言語モデル(LLM)の推論および学習を実行し,使用台数(node 数)とノード間接続方式(RJ45 Ethernet スイッチ/QSFP 直結/QSFP スイッチ)が処理速度に与える影響を評価した結果をまとめたものである。推論の評価には vLLM の公式ベンチマーク(vllm bench serve)を用い,TTFT・TPOT・Throughput の 3 指標で比較した。学習については nanochat による事前学習と,Qwen2.5-7B-Instruct の LoRA/フルファインチューニング(PyTorch DDP)で比較を行った。あわせて,NCCL Test によるノード間帯域の実測と,QSFP スイッチ利用時に発生した通信速度低下問題の原因調査についても報告する。
主要な結論
- 推論:GPT-OSS-120B(MXFP4)を Tensor Parallel で 2 台に分散すると,1 台に比べて TPOT・Throughput が同等〜改善する。これはモデルパラメータと KV キャッシュの読み出しが 2 台の GPU メモリ帯域(各 273 GB/s)に分散されるためである。一方,RJ45 接続のまま 4 台へ増やすと全指標で性能が低下し,ノード間通信帯域がボトルネックとなる。
- 接続方式:2 台構成を RJ45 から QSFP(200 Gbps)に変更するだけで TTFT が最大約 50%,TPOT が約 25〜30% 短縮し,Throughput は最大約 40% 向上した。QSFP 接続を含む 4 台構成では,同時リクエスト数(num-prompts)が多いほど恩恵が大きく,num-prompts=100 では 2 台 QSFP 比で Throughput が約 1.3 倍に達した。
- ノード間帯域:NCCL Test で QSFP スイッチ経由の実効帯域は約 22 GB/s(理論値 25 GB/s)であり,RJ45 スイッチ(約 1.2 GB/s)の約 19 倍である。
- 学習:LoRA(通信量 約 0.005 GB/step)では node 数にほぼ比例して高速化し,RJ45 と QSFP の差は出ない。フルファインチューニング(通信量 約 14 GB/step)では QSFP が RJ45 より 1.3〜1.5 倍高速だが,DDP の勾配同期コストが大きく 1 node が依然として最速である。
- 運用上の注意:稼働中に QSFP ケーブルの接続形態(直結⇔スイッチ)を切り替えると,通信帯域が約 2.8〜3.2 GB/s に固定される現象を確認した。DGX Spark の再起動で回復する。dmesg に PCIe AER の Fatal エラーが記録されており,NIC(ConnectX-7)の PCIe リンク状態異常が疑われるが根本原因は未特定である。
2. 背景と目的
DGX Spark は GB10 Grace Blackwell Superchip を搭載し,128 GB の統合メモリ(LPDDR5x,帯域 273 GB/s)と ConnectX-7 による 200 Gbps のネットワークポート(QSFP)を備えた小型ワークステーションである。単体で 100B クラスの量子化モデルを動作させられる一方,メモリ帯域は HBM 搭載 GPU に比べて低く,デコード時のトークン生成速度がメモリ帯域律速となりやすい。そこで本検討では,複数台の DGX Spark を接続してモデルを分散配置した場合に,(1)推論速度がどのように変化するか,(2)ノード間接続の帯域(RJ45 vs QSFP)がどの程度性能を左右するか,(3)学習ワークロードにおいて同様の傾向が成り立つか,を明らかにすることを目的とした。
3. 評価環境
3.1 ハードウェア構成
| 項目 | 内容 |
|---|---|
| 計算機 | NVIDIA DGX Spark ×4(node15, node16, node17, node18) |
| GPU メモリ | 128 GB(統合メモリ)/台,メモリ帯域 273 GB/s |
| NIC | ConnectX-7(QSFP,200 Gbps ×2 ポート:enp1s0f0np0 / enp1s0f0np1) |
| 低速ネットワーク | RJ45 Ethernet スイッチ(理論値 1〜10 Gbps ) |
| 高速ネットワーク | QSFP ケーブル直結,および MikroTik QSFP スイッチ(型式:CRS812-8DS-2DQ-2DDQ-RM。200G QSFP56 ポート ×2,400G QSFP56-DD ポート ×2(ブレイクアウトケーブルにより 200G ×2 として利用可能)を使用。理論値 200 Gbps,最大 6 台接続可) |
3.2 ネットワーク構成パターン
| 構成 | 台数 | ノード間接続 | 用途 |
|---|---|---|---|
| 1node | 1 | ― | ベースライン |
| 2node (RJ45) | 2 | RJ45 スイッチ | 推論・学習 |
| 2node (QSFP) | 2 | QSFP ケーブル直結 | 推論・学習 |
| 4node (RJ45) | 4 | RJ45 スイッチ | 推論・学習 |
| 4node (QSFP+RJ45) | 4 | 2 台ずつ QSFP 直結+ペア間は RJ45 | 推論(メモリ 256 GB 相当) |
| 2/4node (QSFP switch) | 2〜4 | MikroTik QSFP スイッチ(CRS812-8DS-2DQ-2DDQ-RM) | NCCL Test・学習 |
QSFP 直結のみで 3 台以上を構成する場合,DGX Spark の仕様上「enp1s0f0np0 同士」「enp1s0f0np1 同士」の接続は可能だが np0–np1 間は接続できず,またデイジーチェーン構成では NCCL の全ノード間通信が成立しない組み合わせが生じる。NVIDIA 公式のリング構成(three-sparks-ring)で 3 台までは対応可能だが,4 台以上を全結合するには QSFP スイッチが実質的に必須である。
3.3 ソフトウェア
| 項目 | 内容 |
|---|---|
| 推論エンジン | vLLM(マルチノード Tensor Parallel,vllm bench serve) |
| 推論モデル | GPT-OSS-120B(MXFP4 量子化,MoE 構造,重み約 60 GB) |
| 推論データセット | ShareGPT(num-prompts = 1, 10, 100,一部 250,seed = 42) |
| 事前学習 | nanochat(nanochat.gpt.GPT)/FineWeb-EDU |
| ファインチューニング | Qwen2.5-7B-Instruct,PyTorch DDP,tatsu-lab/alpaca 1,000 件,batch 1,seq 512,1 epoch |
| 通信ライブラリ | NCCL(RoCE / RDMA),NCCL Test で帯域計測 |
4. vLLM と評価指標
4.1 vLLM の概要
vLLM は LLM を高速かつ効率的にサービングするためのオープンソース推論エンジンであり,本検討では以下の 2 つの中核技術が性能を支えている。
- PagedAttention:自己回帰生成では過去トークンの Key/Value(KV キャッシュ)を保持する必要があるが,生成長が事前に分からないため,従来は最大長分を静的に確保して大量の未使用領域(内部断片化)が発生していた。PagedAttention は OS の仮想メモリと同様に KV キャッシュを固定サイズのブロック単位で動的に割当・解放し,メモリ効率を大幅に改善する。これにより同時に処理できるリクエスト数が増加する。
- Continuous Batching:静的バッチではバッチ内の最長リクエストが終わるまで GPU が待機し,後続リクエストのレイテンシも増大する。Continuous Batching はあるリクエストが完了した瞬間にキュー内の次のリクエストをバッチへ投入することで,GPU 稼働率を最大化する。
4.2 ベンチマーク手順(vllm bench serve)
複数ユーザーが API を同時に叩く状況を模擬し,推論サーバの総合性能を測定するツールである。(1)データセット読み込み → (2)num-prompts 件のリクエスト生成 → (3)サーバへ並列・一斉送信 → (4)結果集計,の 4 ステップで実行される。
4.3 評価指標
| 指標 | 定義 | 評価する性質 |
|---|---|---|
| TTFT (Time To First Token) | リクエスト送信後,最初のトークンが返るまでの時間。全リクエストの平均値 | ユーザーが体感する応答速度。主に Prefill(入力処理)の速さ |
| TPOT (Time Per Output Token) | 出力 1 トークンあたりの生成時間。全トークンの平均値 | 文章が生成される速さ。Decode 段階の速さ |
| Throughput | サーバ全体で 1 秒間に生成された出力トークン数(tok/s) | サーバ全体の処理能力 |
なお,TTFT は計算律速(Prefill は行列積が主体),TPOT は主にメモリ帯域律速(Decode は毎ステップ全パラメータと KV キャッシュを読む)という異なる特性を持つため,ハードウェア構成の変更が両者に及ぼす影響は必ずしも一致しない点に留意する。
5. 推論速度評価
以下,1node を基準に,RJ45 で台数を増やした場合(5.1),2 台を QSFP に変更した場合(5.2),QSFP を含む 4 台構成(5.3)の順に結果を示す。表中の num-prompts = 100 の値は,元資料のグラフ画像で該当パネルが一部欠けているため,1node の読取値(TTFT ≈ 486 ms,TPOT ≈ 235 ms,Throughput ≈ 194 tok/s)に資料記載の差分を加算して算出した推定値である(図中はハッチングで表示)。正確な値は元データを参照されたい。
5.1 node 数による変化(RJ45 接続)
| 構成 | TTFT [ms] | TPOT [ms] | Thr. [tok/s] | ||||||
|---|---|---|---|---|---|---|---|---|---|
| np=1 | np=10 | np=100 ※ | np=1 | np=10 | np=100 ※ | np=1 | np=10 | np=100 ※ | |
| 1node | 71.73 | 263.32 | ≈486 | 30.64 | 67.26 | ≈235 | 32.28 | 83.11 | ≈194 |
| 2node (RJ45) | 59.52 | 208.19 | ≈501 | 31.22 | 60.19 | ≈171 | 31.79 | 84.59 | ≈243 |
| 4node (RJ45) | 103.43 | 223.61 | ≈521 | 70.10 | 85.75 | ≈192 | 14.21 | 56.68 | ≈208 |
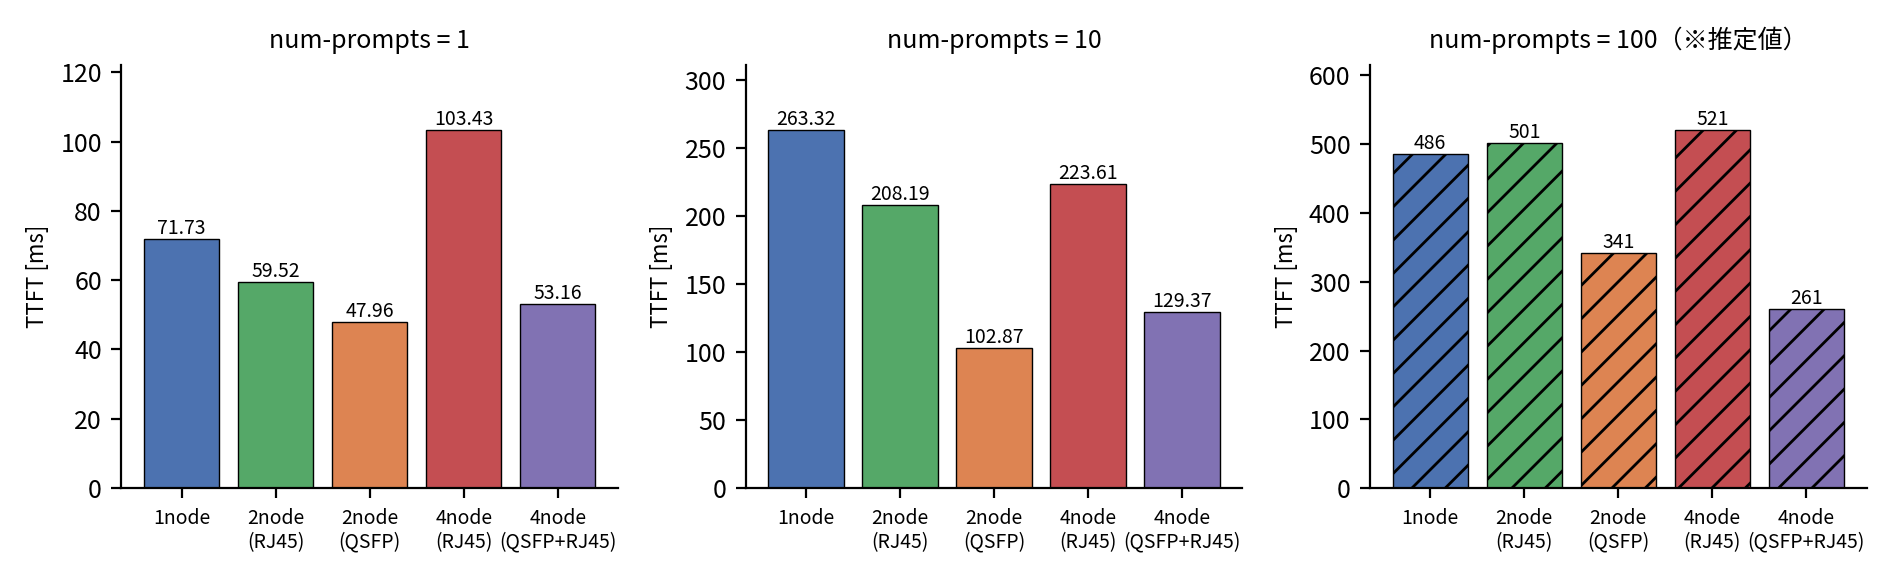
図 1 TTFT の比較(左:num-prompts=1,中:10,右:100(推定))
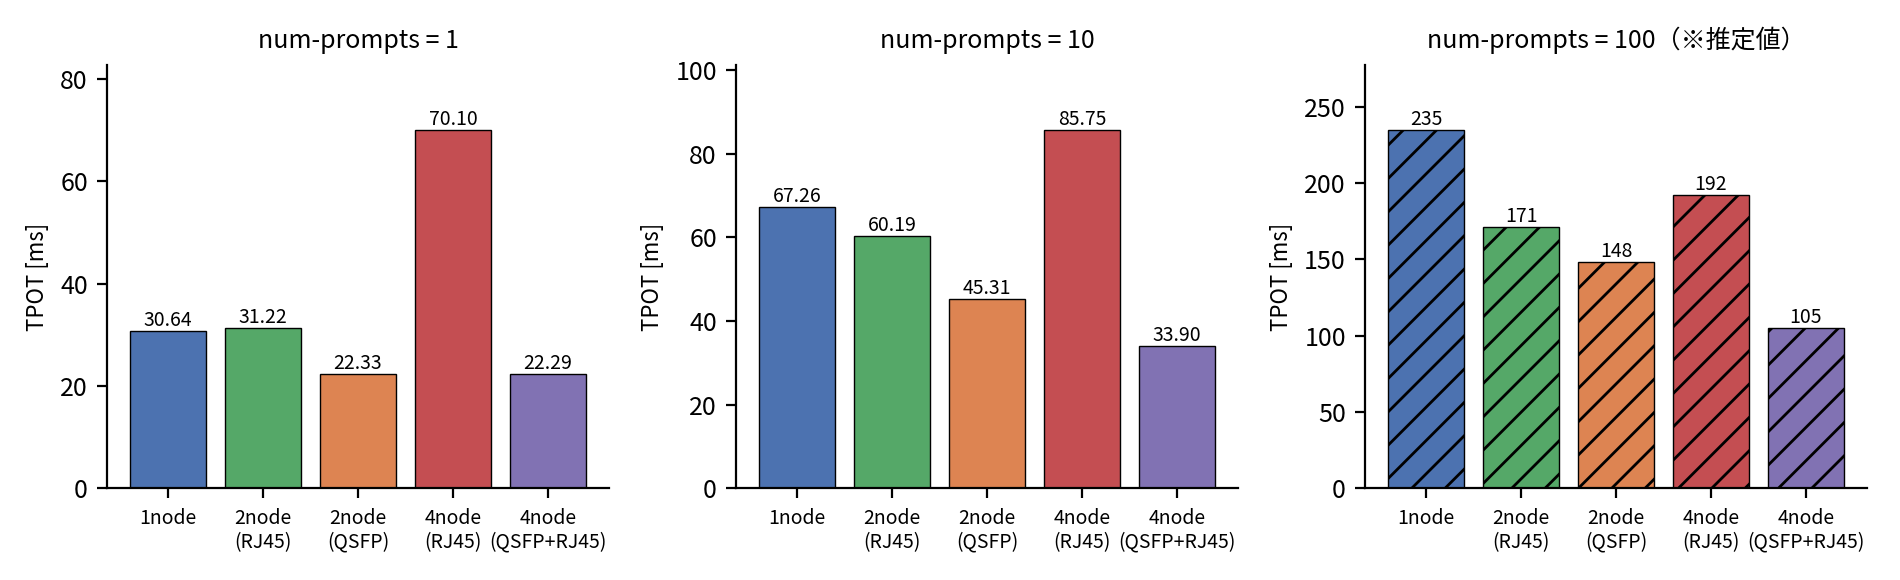
図 2 TPOT の比較
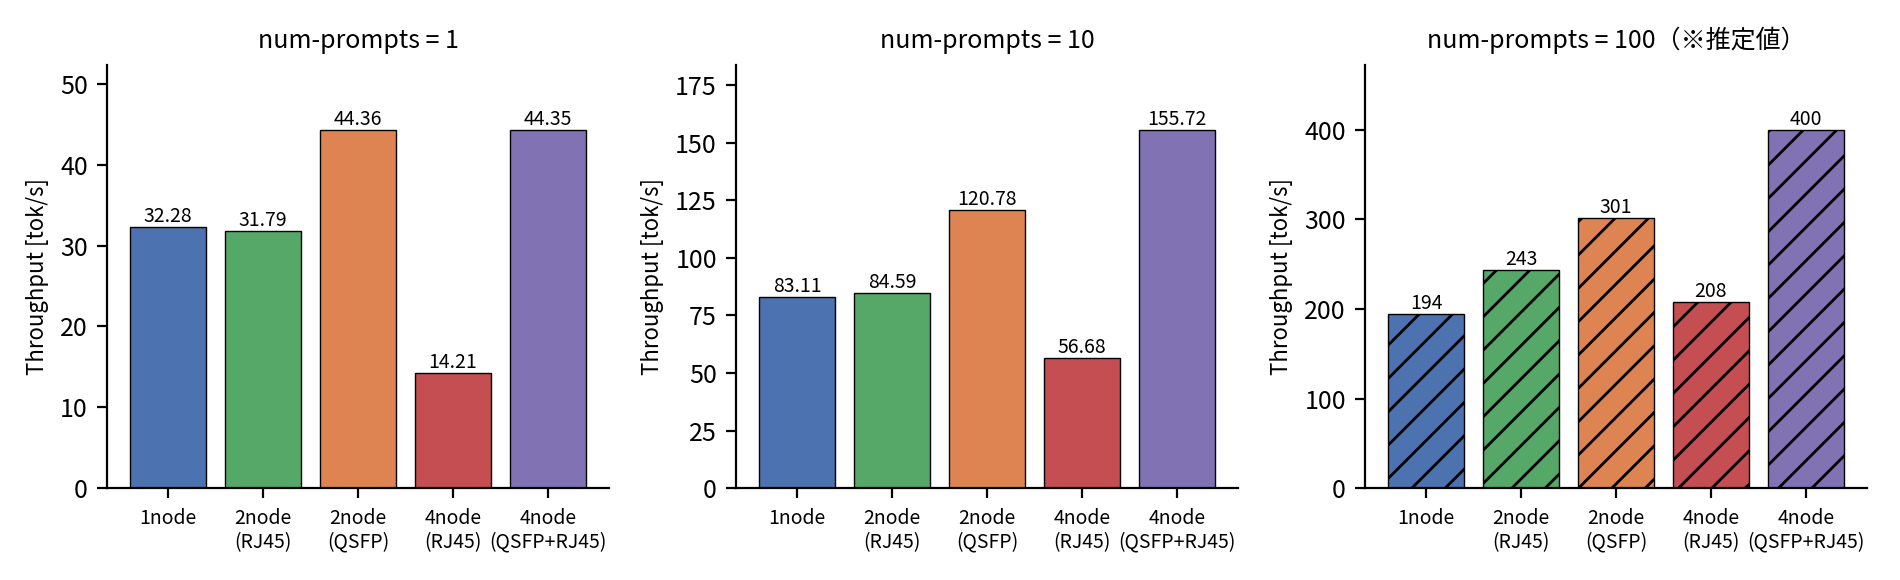
図 3 Throughput の比較
1node → 2node:
- TTFT は np=1, 10 で減少(−12.2 ms,−55.1 ms),np=100 でわずかに増加(+14.7 ms)。
- TPOT は np=1 で同等(+0.6 ms),np=10, 100 で改善(−7.1 ms,−63.6 ms)。Throughput も np=100 で +48.7 tok/s と大きく改善。
- 同時リクエスト数が多いほど Tensor Parallel によるメモリ帯域分散の恩恵が大きく現れる。
2node → 4node(RJ45):
- TTFT・TPOT はすべての np で増加し,Throughput は減少(np=1 で 31.8 → 14.2 tok/s と半減以下)。
- Tensor Parallel ではレイヤーごとに all-reduce が発生するため,node 数増加に伴う通信回数の増加が 1〜10 Gbps の RJ45 帯域では吸収できず,メモリ分散の利得を相殺して性能低下に至る。
5.2 接続方式による変化(2node:RJ45 → QSFP)
| 構成 | TTFT [ms] | TPOT [ms] | Thr. [tok/s] | ||||||
|---|---|---|---|---|---|---|---|---|---|
| np=1 | np=10 | np=100 ※ | np=1 | np=10 | np=100 ※ | np=1 | np=10 | np=100 ※ | |
| 2node (RJ45) | 59.52 | 208.19 | ≈501 | 31.22 | 60.19 | ≈171 | 31.79 | 84.59 | ≈243 |
| 2node (QSFP) | 47.96 | 102.87 | ≈341 | 22.33 | 45.31 | ≈148 | 44.36 | 120.78 | ≈301 |
| 改善率 | −19% | −51% | −32% | −28% | −25% | −14% | +40% | +43% | +24% |
同じ 2 台構成でも接続を QSFP(200 Gbps)に変えるだけで全指標が改善した。特に TTFT の改善幅が大きい(np=10 で約半減)。Prefill ではシーケンス長分の活性化テンソルをノード間で交換するため通信量が Decode より大きく,帯域の影響を強く受けたと解釈できる。TPOT の改善(約 25〜30%)は,1node(30.64 ms)を明確に下回る 22.33 ms を達成しており,「複数台による GPU メモリ帯域の分散 > ノード間通信のオーバーヘッド」という関係が QSFP により成立したことを示す。
なお,元資料の TTFT 差分注記(14.29 ms/160.23 ms/11.56 ms 低下)のうち np=10 の値はグラフ読取値の差(208.19 − 102.87 = 105.32 ms)と一致しない。異なる試行の値が混在している可能性があるため,本レポートではグラフ値を採用した。
5.3 QSFP を含む 4 台構成(QSFP ペア ×2 を RJ45 で接続)
| 構成 | TTFT [ms] | TPOT [ms] | Thr. [tok/s] | ||||||
|---|---|---|---|---|---|---|---|---|---|
| np=1 | np=10 | np=100 ※ | np=1 | np=10 | np=100 ※ | np=1 | np=10 | np=100 ※ | |
| 2node (QSFP) | 47.96 | 102.87 | ≈341 | 22.33 | 45.31 | ≈148 | 44.36 | 120.78 | ≈301 |
| 4node (QSFP+RJ45) | 53.16 | 129.37 | ≈261 | 22.29 | 33.90 | ≈105 | 44.35 | 155.72 | ≈400 |
| 差分 | +5.2 | +26.5 | −79.4 | −0.04 | −11.4 | −43.3 | −0.01 | +34.9 | +99.1 |
- TTFT は np=1, 10 で 2node (QSFP) よりわずかに悪化するが,np=100 では大幅に改善した。
- TPOT・Throughput は同時リクエスト数が多いほど改善幅が大きい(np=100 で Throughput 約 1.3 倍)。
- 合計 256 GB のメモリにより KV キャッシュ用の空き容量が増え,同時に処理できるリクエスト数(実効バッチサイズ)が増加したことが高負荷時の性能向上の主因と考えられる。低負荷時(np=1)はペア間 RJ45 リンクの通信コストがそのまま現れる。
5.4 考察:2 種類の帯域のトレードオフ
複数台推論では,(a)GPU メモリ帯域(統合メモリ ⇔ 演算コア間,273 GB/s)と,(b)ネットワーク帯域(ノード間,RJ45 ≈ 1.2 GB/s,QSFP ≈ 22 GB/s 実測)の 2 種類の帯域が性能を決める。1 台構成では,Decode の各ステップで約 60 GB のパラメータと KV キャッシュを毎回メモリから読み出す必要があり,メモリ帯域が飽和して推論速度の上限となる。Tensor Parallel で N 台に分散すると各台が読み出すパラメータは 1/N になり(2 台なら約 30 GB),メモリ帯域に余裕が生まれて TPOT が改善する。一方で各レイヤー後に部分結果を all-reduce で交換する必要があり,その通信コストが N とともに増加する。したがって,
- メモリ帯域の分散による利得 > ネットワーク通信コスト → 複数台で高速化(2node,特に QSFP)
- メモリ帯域の分散による利得 < ネットワーク通信コスト → 複数台で低速化(4node RJ45)
という関係で整理できる。RJ45 の帯域はメモリ帯域の約 1/200 以下であるため,ノード数を増やすほど通信コストが支配的になる。QSFP でもメモリ帯域の約 1/12 に留まるが,2〜4 台の範囲では利得が上回ることが本実験で確認された。
第2回では,ノード間帯域を NCCL Test で実測した結果と,事前学習・LoRA/フルファインチューニングの学習速度評価をお届けします。
→ 第2回:ノード間帯域の実測(NCCL Test)と学習速度評価
NVIDIA DGX Spark の詳細・お見積りは以下をご覧ください。