search製品名・スペックから検索


【第2回】DGX Spark 複数台接続による LLM 推論・学習速度の評価 ~帯域実測・学習編~
編集部より
NVIDIA DGX Spark を1〜4台接続したクラスタで LLM を動かした評価レポート、今回は第2回となります。
第1回では、推論において「2台構成の接続を RJ45 から QSFP に変えるだけで TTFT が最大約 50% 短縮、Throughput は最大約 40% 向上する」「RJ45 のまま4台に増やすと全指標が低下する」という結果が示されました。
今回は、その通信帯域そのものを NCCL Test で実測した結果と、学習ワークロードでの評価をお届けします。
- 第1回:概要/背景と目的/評価環境/vLLM と評価指標/推論速度評価
- 第2回(本記事):ノード間帯域の実測(NCCL Test)/学習速度評価
- 第3回:QSFP スイッチ利用時の通信速度低下問題/補足事項/まとめと今後の予定
以下、評価環境の詳細は第1回をご参照ください。
6. ノード間帯域の実測(NCCL Test)
QSFP スイッチ導入後,クラスタが正常に動作するかを NCCL Test(学習は行わず GPU 間の集団通信速度のみを計測するベンチマーク)で確認した。
| 構成 | 計測値 [GB/s] | 理論値 [GB/s] | 実効率 |
|---|---|---|---|
| 2 台 QSFP 直結 † | 21.77 | 25 | 87% |
| 2 台 QSFP スイッチ | 22.14 | 25 | 89% |
| 4 台 QSFP スイッチ | 22.07 | 25 | 88% |
| 4 台 RJ45 スイッチ(10 GbE) | 1.18 | 1.25 | 94% |
† 計測時の設定が他と少し異なるため参考値
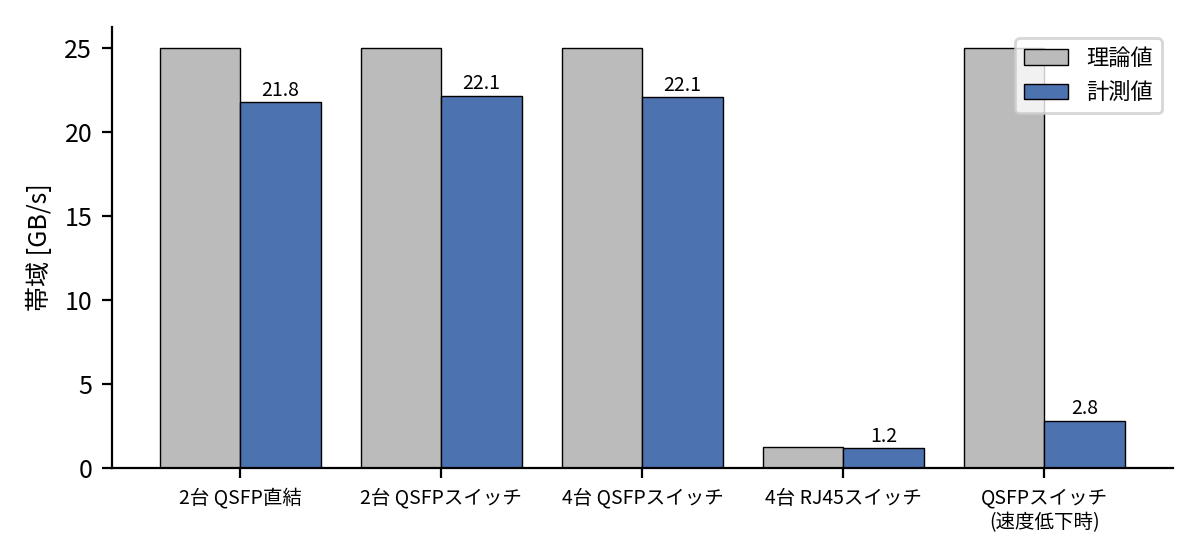
図 4 NCCL Test によるノード間帯域(右端は第 8 章の速度低下状態)
QSFP スイッチ経由で理論値 25 GB/s に対し約 22 GB/s を確認した。他者の報告例(QSFP 直結で約 20 GB/s)と同等以上であり,妥当な結果である。また 2 台と 4 台で帯域がほぼ変わらないことから,スイッチによるオーバーサブスクリプションは発生していない。RJ45 との差は約 19 倍である。
7. 学習速度評価
7.1 nanochat による事前学習(node 数・接続方式)
nanochat(GPT モデル,FineWeb-EDU)で node 数(1, 2, 4)と接続方式(RJ45, QSFP)を変えて学習し,1 秒あたりの処理トークン数(tok/s)と損失の推移を比較した。
| 構成 | tok/s | 備考 |
|---|---|---|
| 1node | 9,945.5 | ― |
| 2node (RJ45) | 10,742.9 | node 増加による伸びは小さい |
| 4node (RJ45) | 9,691.3 | 1node を下回る |
| QSFP 接続 | (大幅に増加) | 資料のグラフ画像が欠損しており数値未取得 |
- RJ45 接続では node 数を増やしても tok/s はほとんど増えず,4node ではむしろ低下した。損失曲線でも node 数の増加とともに同一損失に到達する時間が長くなっており,RJ45 帯域が勾配同期のボトルネックになっている。
- 接続方式を QSFP に変更すると tok/s が大幅に増加し,損失到達時間も大幅に短縮した。通信帯域のボトルネックが解消され,データ並列のスケーリングが有効に機能する。
7.2 Qwen2.5-7B-Instruct の LoRA/フルファインチューニング(PyTorch DDP)
DDP は各 node がミニバッチを独立に処理し,イテレーションごとに勾配を all-reduce で共有する方式である。通信量は学習対象パラメータ数に比例するため,LoRA(rank 8,2,523,136 パラメータ ≈ 0.0047 GB)とフルファインチューニング(7,615,616,512 パラメータ ≈ 14.19 GB)で通信帯域の影響が大きく異なることが予想される。以下は QSFP スイッチ導入後の最新の計測値である。
LoRA チューニング
| 構成 | throughput [samples/s] ↑ | elapsed [s] ↓ | avg step time [s] ↓ |
|---|---|---|---|
| 1node | 2.14 | 465.4 | 0.450 |
| 2node-RJ45 スイッチ | 4.17 | 237.2 | 0.461 |
| 2node-QSFP スイッチ | 4.20 | 235.9 | 0.460 |
| 4node-RJ45 スイッチ | 8.28 | 118.3 | 0.465 |
| 4node-QSFP スイッチ | 8.29 | 118.2 | 0.466 |
フルファインチューニング
| 構成 | throughput [samples/s] ↑ | elapsed [s] ↓ | avg step time [s] ↓ |
|---|---|---|---|
| 1node | 0.43 | 2,294.8 | 2.289 |
| 2node-RJ45 スイッチ | 0.13 | 7,344.0 | 14.818 |
| 2node-QSFP スイッチ | 0.18 | 5,496.6 | 11.087 |
| 4node-RJ45 スイッチ | 0.19 | 5,231.0 | 21.331 |
| 4node-QSFP スイッチ | 0.28 | 3,557.0 | 14.501 |
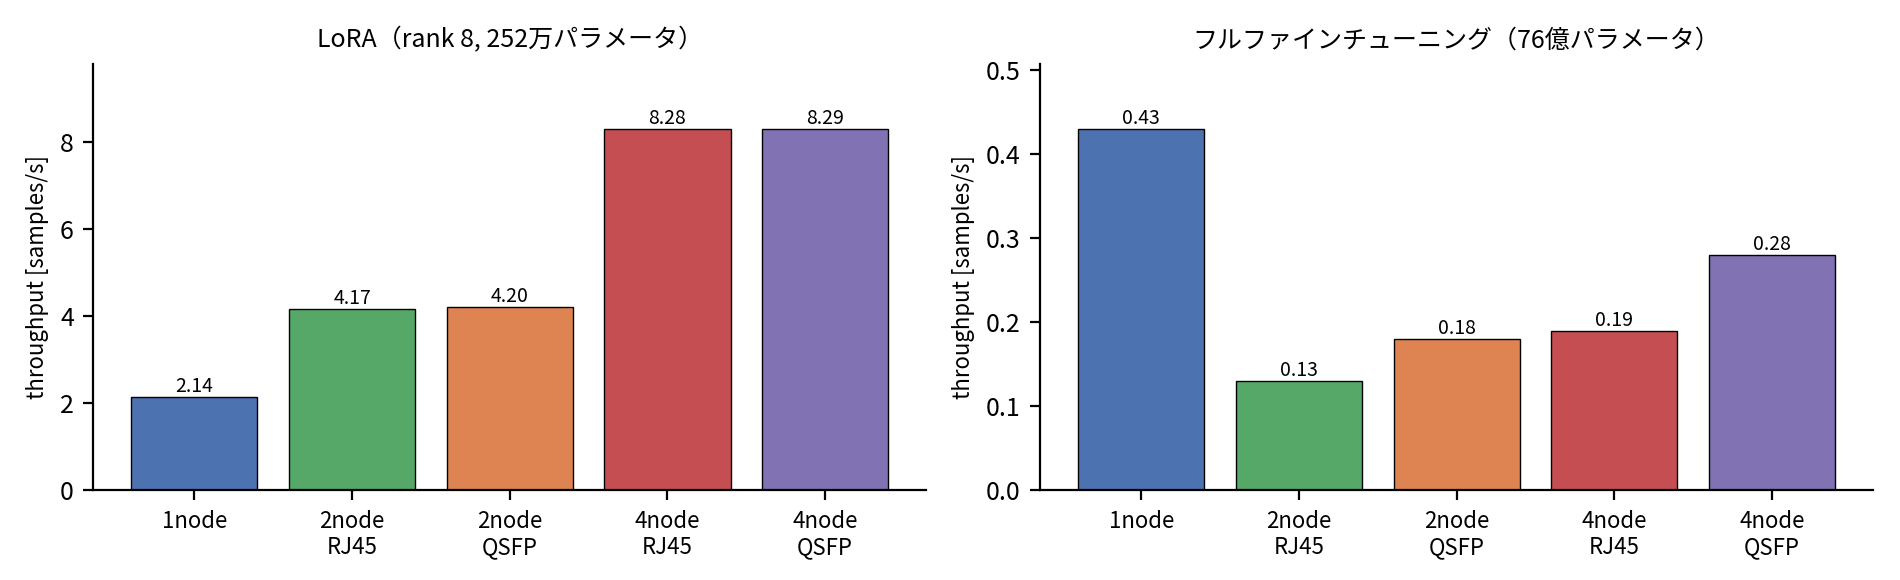
図 5 DDP 学習の throughput(左:LoRA,右:フルファインチューニング)
LoRA:
-
- node 数にほぼ比例して throughput が向上(2.14 → 4.2 → 8.3 samples/s),step time もほぼ一定(0.45〜0.47 s)で理想的なスケーリングを示す。
- RJ45 と QSFP の差はほとんどない。共有する勾配が約 5 MB と小さく,RJ45 でも通信時間が無視できるためである。
フルファインチューニング:
- QSFP は RJ45 より一貫して高速(2node で 1.34 倍,4node で 1.47 倍)。約 14 GB の勾配同期に帯域が直接効く。
- しかし node 数を増やすと 1node より遅くなり(step time が 2.3 s → 11〜21 s),1node が最速である。DDP では全 node が 14 GB の勾配を毎ステップ交換するため,QSFP(約 22 GB/s)でも同期に 1 秒以上を要し,計算時間(約 2.3 s)に対して無視できない。
- 2node-RJ45 が 4node-RJ45 より遅い,QSFP の帯域比(約 19 倍)に対して速度差が 1.3〜1.5 倍に留まる,といった帯域だけでは説明できない挙動が残っており,通信以外の処理(勾配のバケット化,all-reduce アルゴリズムの選択,CPU オフロード等)がボトルネックになっている可能性がある。原因は調査中である。
第3回では、QSFP スイッチ利用時に発生した通信速度低下問題の原因調査、複数台構成の実務上の補足事項、そしてワークロード別の推奨構成をお届けします。
→ 第3回:QSFP スイッチ利用時の通信速度低下問題と、複数台運用の指針
NVIDIA DGX Spark の詳細・お見積りは以下をご覧ください。